Personnaliser une IA générative avec un RAG simple
Le projet
Chatbot interne permettant d'interroger en langage naturel une documentation métier spécifique, via une architecture RAG simple. Le projet démontre par ailleurs qu'un modèle de langage léger enrichi documentairement surpasse un modèle plus puissant privé de contexte.
Cette version de RAG simple constitue un socle pédagogique volontairement épuré. Un RAG destiné à la production s'appuie sur des briques plus avancées : découpage documentaire (chunking) optimisé, recherche hybride combinant vectoriel et lexical (BM25), ré-ordonnancement des passages par un reranker, reformulation et expansion de requête, compression de contexte, garde-fous contre l'hallucination et évaluation continue de la qualité des réponses. Ces briques feront l'objet d'une prochaine itération du projet.
La valeur
Un modèle généraliste ne connaît pas la documentation interne d'une organisation. Interrogé sur un référentiel métier précis, il répond de façon vague, voire fausse ; l'utilisateur retourne alors chercher lui-même l'information dans les documents.
Le chatbot développé ici répond à partir de la documentation fournie : les réponses sont fiables et sourcées, car ancrées dans le contexte documentaire plutôt que dans les connaissances générales du modèle. Le temps passé à rechercher une information se réduit.
Ce projet démontre également qu'un modèle léger couplé à un RAG simple surpasse un modèle plus puissant sans enrichissement documentaire. Un résultat aux conséquences directes sur les coûts d'inférence : la pertinence des réponses tient à la qualité de l'ancrage documentaire, pas à la puissance brute du modèle. Autrement dit, la valeur vient de la pertinence du contexte fourni, non de la complexité de l'architecture.
La stack technique
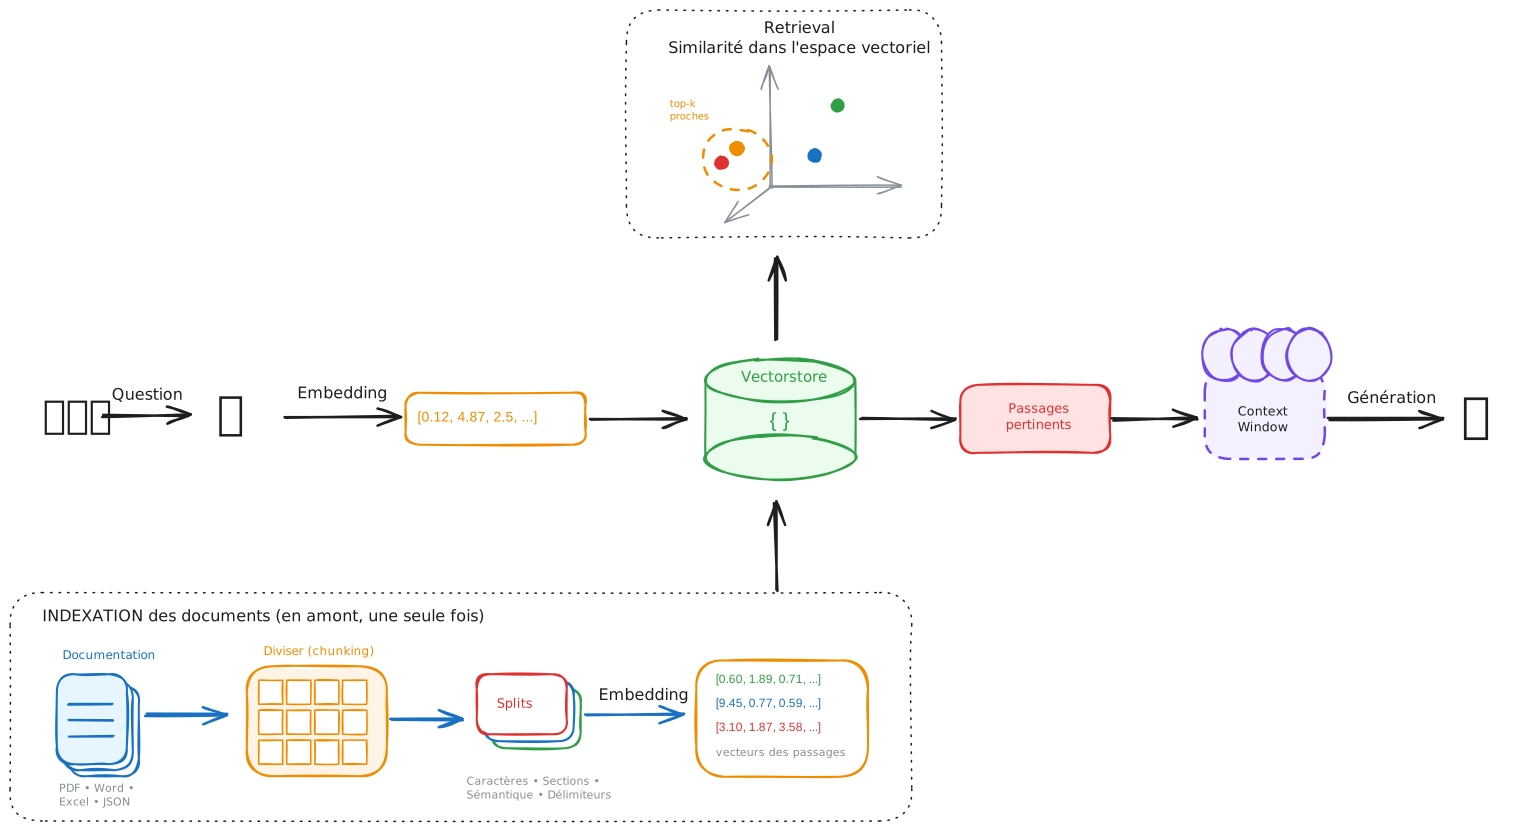
L'architecture RAG (Retrieval-Augmented Generation) est ici volontairement simplifiée : la question de l'utilisateur déclenche une recherche vectorielle sur les documents, puis la réponse est générée à partir des seuls passages retrouvés. Aucun ré-ordonnancement des résultats, aucune reformulation de requête, aucun agent : le socle est réduit à l'essentiel pour donner à voir le fonctionnement de base d'un RAG.
La génération repose sur l'API OpenAI. Les documents sont vectorisés puis stockés dans la base vectorielle Pinecone, et l'orchestration entre le modèle et cette base est assurée par LangChain. L'ensemble est exposé dans une application web déployée avec Streamlit.