Challenger les modèles hybrides par le Machine Learning
Le projet
Modéliser une approche Machine Learning pour challenger les modèles de notation hybrides du risque de crédit sur les portefeuilles Low Default : traitement du déséquilibre extrême des données et explicabilité des modèles « boîte noire ».
La valeur
Les modèles de notation hybrides, souvent présents pour des portefeuilles avec une faible volumétrie de défaut, combinent expertise humaine et statistiques. Cette part de jugement les rend moins reproductibles d'un analyste à l'autre et plus coûteux à maintenir dans la durée.
L'objectif est de les challenger par une approche purement statistique, fondée sur les seules données financières des contreparties, sans intervention subjective dans leur notation, et d'améliorer ainsi le pouvoir prédictif du modèle.
Deux difficultés : le déséquilibre extrême des portefeuilles Low Default, les défauts y sont si rares que la cible d'un apprentissage supervisé n'est représentée qu'en très faible quantité et l'explicabilité, un modèle de Machine Learning performant mais opaque ne passe pas pour la conformité réglementaire.
Le projet traite les deux de front : rééquilibrage des données, interprétabilité des prédictions. La démarche ne vise pas à remplacer le modèle hybride en production, mais à les challenger : sur un portefeuille où les défauts sont rares, le jugement d'expert conserve sa place, et l'approche ML apporte un point de comparaison statistique objectif sur la performance du modèle.
La stack technique
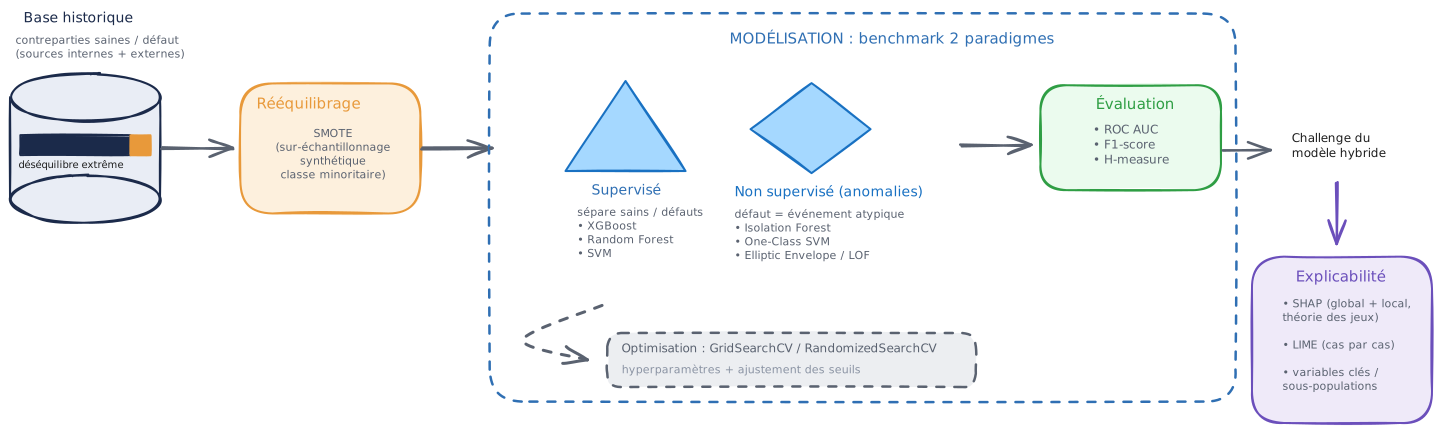
Les données proviennent d'une base historique de contreparties saines et en défaut, constituée à partir de sources internes et externes. La rareté des défauts est traitée par SMOTE (Synthetic Minority Over-sampling Technique), qui sur-échantillonne synthétiquement la classe minoritaire, complété par un ajustement du seuil de classification.
La modélisation s'appuie sur Python et scikit-learn. Le benchmark confronte deux paradigmes complémentaires : des modèles supervisés (XGBoost, Random Forest, SVM), qui apprennent à séparer sains et défauts à partir des cas connus, et des algorithmes non supervisés de détection d'anomalies (Isolation Forest, One-Class SVM, Elliptic Envelope, Local Outlier Factor), qui traitent le défaut comme un événement atypique à isoler.
Ce second angle est particulièrement adapté au Low Default, où les défauts sont trop rares pour être appris comme une classe ordinaire. Les modèles sont évalués par ROC AUC, F1-score et H-measure.
L'explicabilité repose sur deux outils complémentaires : SHAP, fondé sur la théorie des jeux, pour une attribution cohérente des contributions à l'échelle globale comme locale, et LIME pour une lecture rapide, cas par cas, d'une prédiction individuelle. L'identification des variables clés et l'analyse des résultats par sous-population rendent les modèles « boîte noire » transparents et auditables.
L'optimisation enfin s'appuie sur GridSearchCV et RandomizedSearchCV pour la recherche d'hyperparamètres, et sur l'ajustement des seuils de classification.