Algorithme génétique pour le risque de crédit
Le projet
Développement from scratch d'un algorithme génétique en Python pour calibrer les modèles de notation du risque de crédit sur les portefeuilles Low Default, où la rareté des défauts observés met en échec les méthodes statistiques classiques de modélisation (régression logistique, arbre de décision).
La valeur
Dans le cadre du projet IRB Repair de mise en conformité réglementaire, les modèles de notation Low Default Portfolio (LDP) devaient être refondus. Sur ces portefeuilles, les défauts sont si rares que la calibration ne peut plus s'appuyer sur leur fréquence : elle repose sur le jugement d'expert.
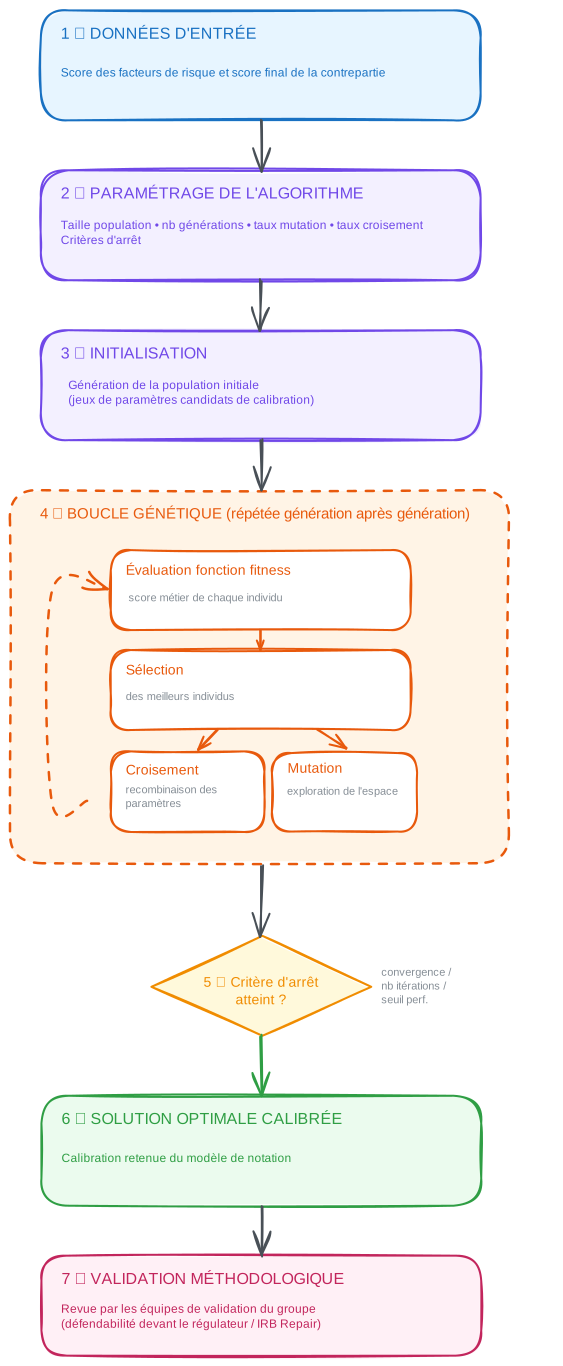
Concrètement, l'algorithme cherche les meilleures pondérations à attribuer à chaque facteur de risque, de façon à reproduire au plus près les scores finaux issus de décisions d'expert sur un échantillon représentatif de contreparties du portefeuille. Le problème est combinatoire : l'espace des pondérations possibles est trop vaste pour être exploré à la main ou par les méthodes statistiques classiques, mises en échec par la faible volumétrie.
L'algorithme génétique, inspiré de la théorie de l'évolution, répond précisément à ce type d'optimisation : il converge vers une solution quasi optimale en simulant sélection, croisement et mutation.
Mais la performance ne suffit pas : dans un contexte réglementaire, une calibration doit être défendable devant un régulateur. C'est là le véritable différenciateur de l'approche. Chaque pondération retenue est traçable génération après génération, ce qui rend la calibration explicable et auditable, à l'opposé d'une boîte noire. Validée méthodologiquement par les équipes de validation du groupe, la solution est déployée en production.
La stack technique
Algorithme génétique développé from scratch en Python, avec un paramétrage flexible : taille de la population, nombre de générations, taux de mutation et taux de croisement.
La fonction d'optimisation (fitness) mesure l'écart entre les scores reconstitués par les pondérations candidates et les scores cibles notés à dire d'expert ; les contraintes de l'espace de recherche ont été définies avec les équipes métier. Les critères d'arrêt sont paramétrables (convergence, nombre d'itérations, seuil de performance), et l'équilibre entre exploration et exploitation est piloté pour éviter les optima locaux.
Robustesse : tests de pertinence et de stabilité de la solution sur plusieurs itérations, puis validation méthodologique par les équipes de validation du groupe.
Industrialisation : code Python modulaire, documenté et évolutif, avec traçabilité des résultats à chaque génération, condition nécessaire à l'explicabilité exigée dans un contexte réglementaire.